
Gleiche Frage, gleicher Seed, zwei Berichte: Was KI-Antworten in der Forensik reproduzierbar macht
Wer einen KI-Bericht in eine Akte legt, muss erklären können, wie er entstand, und ein Zweiter muss ihn nachvollziehen können. Wir haben gemessen, warum dieselbe Frage an ein Sprachmodell zwei verschiedene Berichte ergeben kann, was sich dagegen tun lässt, und wo die Grenze liegt. Die Ergebnisse stehen in einem neuen Whitepaper, das Sie bei uns anfordern können.
Sprachmodelle sind in der Blockchain-Forensik inzwischen Alltag: Sie fassen Transaktionsketten zusammen, formulieren Berichte und schlagen nächste Schritte vor. Sie haben aber eine Eigenschaft, die sich mit forensischer Arbeit schlecht verträgt. Dieselbe Frage ergibt nicht zuverlässig dieselbe Antwort. Wer einen KI-Bericht in eine Akte legt, muss vor Gericht oder gegenüber dem Auftraggeber erklären können, wie er zustande kam, und im Zweifel muss ein zweiter Sachverständiger ihn mit denselben Mitteln nachvollziehen können.
Wir haben uns diese Frage am eigenen KI-Assistenten des Coinators vorgenommen, mit einem lokal gehosteten Modell, und dabei mehr gelernt, als wir erwartet hatten.
Ein Experiment mit überraschendem Ausgang
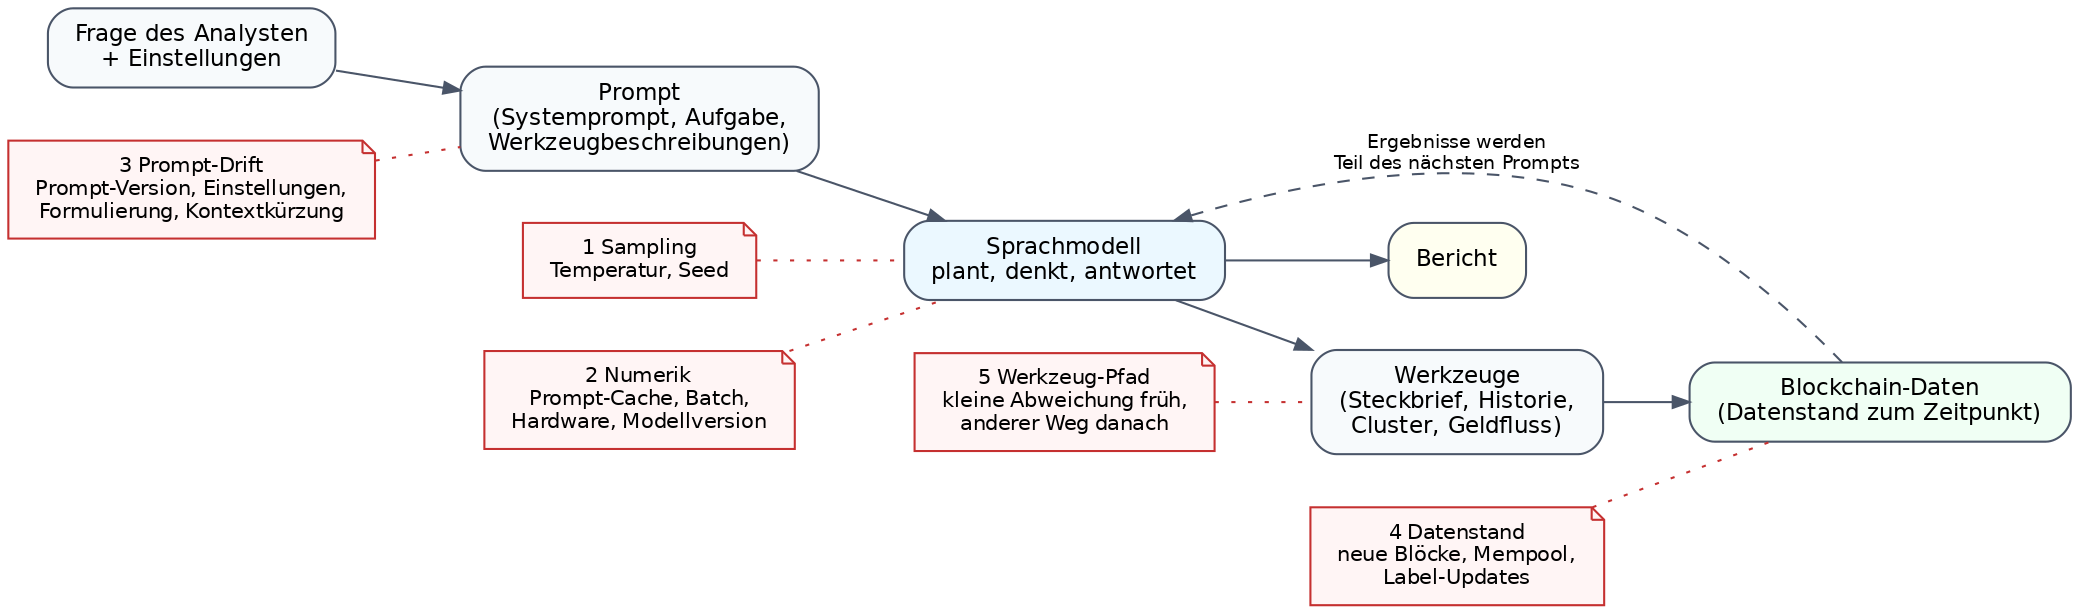
Die Ausgangslage schien einfach. Ein Sprachmodell erzeugt Text Stück für Stück und wählt an jeder Stelle unter mehreren möglichen Fortsetzungen. Diese Auswahl ist zufällig, lässt sich aber abschalten: Temperatur 0 nimmt immer die wahrscheinlichste Fortsetzung, ein fester Startwert (Seed) macht den verbleibenden Zufall wiederholbar. Beides eingestellt, dieselbe Frage zweimal gestellt, zwölf Minuten auseinander. Ergebnis: zwei Berichte, die dieselben Fakten nannten, aber verschiedene Wege gegangen waren, mit anderen Zwischenschritten, anderer Reihenfolge und einem zusätzlichen Nebenbefund im zweiten Lauf.
Die Suche nach der Ursache führte nicht zum Zufall, sondern zur Rechentechnik. Ein Inferenz-Server hält den Anfang eines Prompts im Zwischenspeicher, um Rechenzeit zu sparen. Der zweite Lauf fand den Anfang des ersten dort vor und verarbeitete ihn numerisch minimal anders. An einer Stelle, an der zwei Fortsetzungen fast gleich wahrscheinlich waren, kippte die Entscheidung. Ohne Zwischenspeicher lieferte derselbe Prompt dreimal wortgleich dieselbe Antwort.
Damit war die erste Lektion klar: Temperatur 0 und ein fester Seed sind nur die halbe Antwort. Wiederholbar wird ein Modell erst, wenn auch die Verarbeitung des Prompts jedes Mal gleich abläuft.
Die Grenze heißt Blockchain
Mit abgeschaltetem Zwischenspeicher waren die ersten beiden Runden zweier Läufe identisch bis aufs Byte. In der dritten Runde trennten sie sich erneut, diesmal aus einem Grund, den keine Einstellung beheben kann. Eine der abgefragten Adressen war die Hot-Wallet einer Börse, und zwischen den beiden Läufen waren neue Blöcke bestätigt worden. Saldo und letzte Transaktion waren andere, also sah das Modell andere Daten und plante anders weiter.
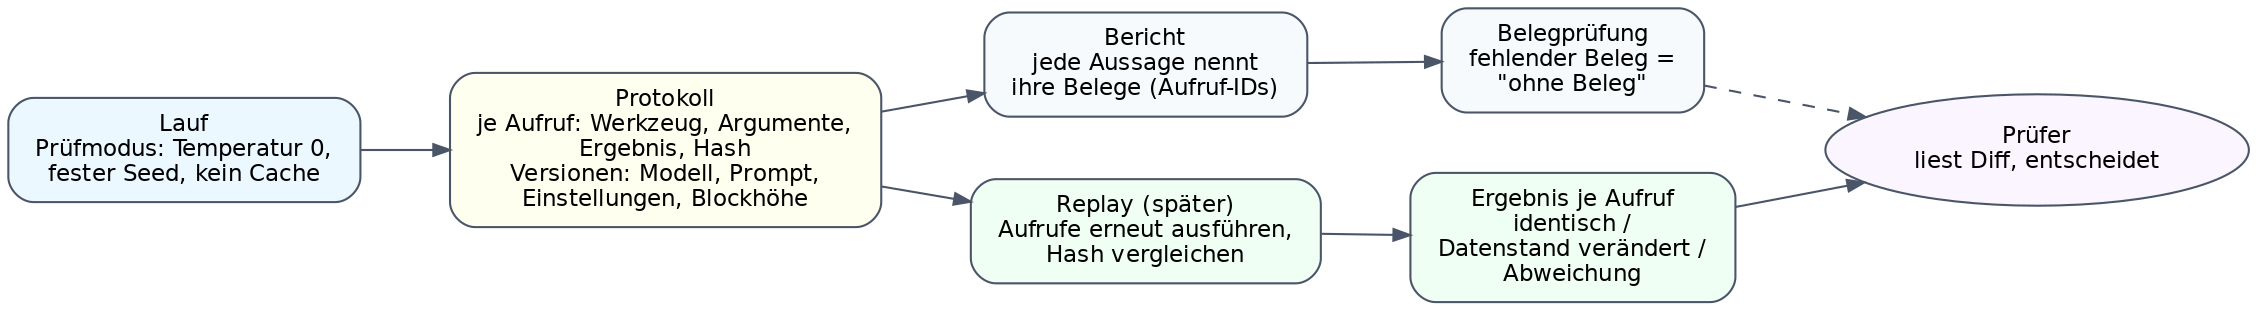
Das ist kein Rauschen des Modells, sondern die Blockchain selbst. Eine Adresse, die seit Monaten ruht, ergibt heute und in einem Jahr denselben Bericht. Eine lebendige Adresse ergibt ihn nur, solange kein neuer Block ihre Werte ändert. Für die Forensik heißt das: Wiederholbarkeit des Textes ist ein erreichbares, aber schmales Ziel. Das Ziel, das trägt, ist Nachvollziehbarkeit: Jede Aussage im Bericht zeigt auf eine protokollierte Abfrage, und diese Abfrage lässt sich später erneut ausführen und vergleichen.
Genau so haben wir es im Coinator gebaut. Ein Prüfmodus setzt Temperatur, Seed und Zwischenspeicher so, dass der Modellanteil eines Laufs wiederholbar ist. Jeder Bericht trägt ein Protokoll aller Werkzeugaufrufe, und ein Replay führt diese Aufrufe später erneut aus und benennt je Aufruf, ob das Ergebnis identisch ist oder ob sich der Datenstand geändert hat. In unserer Probe waren 19 von 22 Abfragen eines Vortagesberichts am nächsten Morgen identisch; die drei Abweichungen gehörten zu einer Adresse, die über Nacht ausgegeben worden war.
Und die Daten?
Die zweite Hälfte der Frage betrifft nicht die Antwort, sondern die Eingabe. Wer Adressen, Transaktionen, Fallzusammenhänge und womöglich Namen von Geschädigten in den Chat eines Cloud-Anbieters tippt, übermittelt personenbezogene Daten an einen Auftragsverarbeiter, häufig in ein Drittland, mit Aufbewahrungsfristen und Nutzungsrechten, die im Vertrag stehen und nicht in der Oberfläche. Das ist kein Grund, auf Sprachmodelle zu verzichten. Es ist ein Grund, vorher zu prüfen, was übermittelt wird und wohin.
Der Coinator geht hier einen anderen Weg: Das Modell läuft auf unseren eigenen Servern, erreichbar nur aus der Plattform heraus, ohne Internetzugang und ohne Anbieter dazwischen. Falldaten verlassen die Infrastruktur nicht, es gibt keine Trainingsnutzung und keine fremden Fristen. Das Modell sieht zudem keine Rohdaten, sondern nur gekürzte Werkzeug-Ergebnisse; die vollständigen Daten bleiben im Protokoll beim Anwender.
Das Whitepaper
Die vollständige Messreihe, die fünf Quellen von Abweichung, eine Prüfkette für den eigenen KI-Einsatz, die Fallstricke beim Arbeiten mit Chat-Diensten und eine Prüfliste zum Datenschutz haben wir in einem neunseitigen Whitepaper zusammengefasst: "Reproduzierbarkeit von KI-Antworten in der Blockchain-Forensik". Es richtet sich an Forensiker, Ermittler und Sachverständige, die Sprachmodelle wie GPT oder Claude bereits einsetzen oder es vorhaben, und ist produktneutral geschrieben; der Coinator kommt erst im letzten Abschnitt vor.
Sie können das Whitepaper kostenlos über unser Kontaktformular anfordern. Nennen Sie als Betreff "Whitepaper Reproduzierbarkeit", wir senden es Ihnen als PDF zu, auf Deutsch oder auf Englisch.